
«Не надо резервировать всё»: Роман Третьяков — о новой реальности ЦОДов, скрытой инфраструктуре и цене отказоустойчивости
Можно ли построить инфраструктуру, которую невозможно вывести из строя? И что делать бизнесу, если даже резервная площадка больше не гарантирует непрерывность сервисов?
Еще недавно отказоустойчивость воспринималась прежде всего как инженерная задача: достаточно предусмотреть резервные мощности, распределить нагрузку между площадками и разработать план аварийного восстановления. Но сегодня привычная логика оказывается под вопросом. К традиционным рискам добавляются физические угрозы для дата-центров, новые сценарии кибератак и растущая стоимость вычислительного оборудования.
Нужно ли отказываться от крупных централизованных ЦОДов в пользу небольших распределенных площадок? Способны ли гибридные облака защитить бизнес? И как обеспечить непрерывность критических сервисов, не увеличивая инфраструктурный бюджет в несколько раз?
Об этом мы поговорили с Романом Третьяковым, IT-экспертом с 20-летним опытом работы в Сбербанке, Банке России и VK. Роман участвовал в создании высоконадежных платежных систем и инфраструктуры денежного обращения, а сегодня занимается проектами строительства центров обработки данных в Узбекистане.
Разговор получился не только о технологиях, но и о необходимости пересмотреть сами принципы построения IT-инфраструктуры.
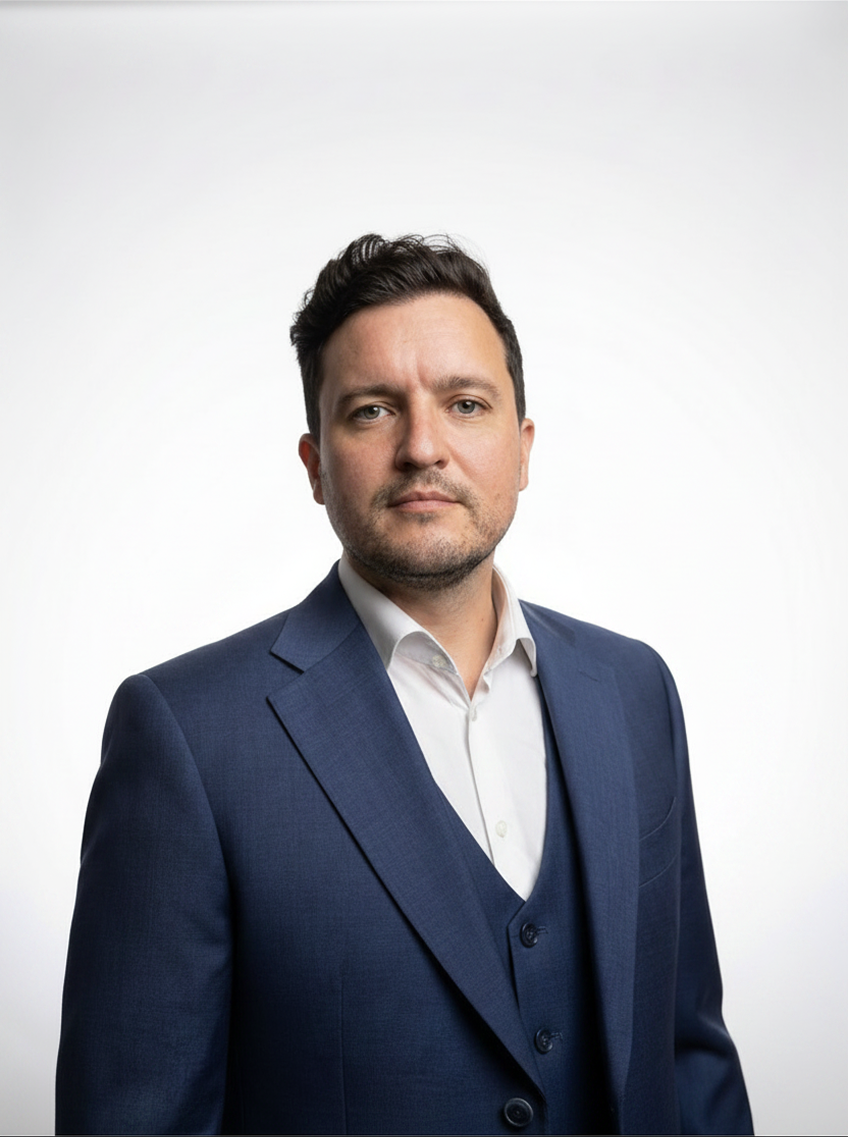
«Мы всегда задавали вопрос: а что будет, если откажет вторая площадка?»
— Роман, начнем с главного. Как сегодня обеспечивать непрерывность критических сервисов, если из строя может выйти не отдельное оборудование, а целый центр обработки данных?
— Я на протяжении 20 лет работал в крупных компаниях — Сбербанке, Центральном банке Российской Федерации, VK. В Сбербанке и Банке России занимался созданием платежных систем, систем наличного денежного обращения. То есть систем, которые должны работать с очень высокой степенью надежности и отказоустойчивости.
В том числе я прошел путь централизации этих систем: от региональных компонентов до больших централизованных решений, размещенных в ЦОДах.
И риск, о котором мы сейчас говорим, на самом деле всегда витал в воздухе.
Мы всегда задавали себе вопрос: а что будем делать, если откажет одна площадка? Ну, будем работать на второй. А если откажет вторая? Значит, должна быть третья площадка либо площадка долгосрочного хранения данных.
Но сейчас мы видим, что эти сценарии перестали быть исключительно теоретическими.
В феврале 2026 года я находился в Эмиратах, когда началась эскалация конфликта между Ираном и США. Тогда пострадала инфраструктура облачных ЦОДов Amazon, что привело к серьезным нарушениям в работе ряда финансовых сервисов.
Для меня это стало еще одним подтверждением: подобные риски нужно учитывать не когда что-то уже произошло, а на этапе проектирования архитектуры.
Сегодня я бы выделил три основные угрозы.
Первая — физические угрозы инфраструктуре. Это воздействие на центры обработки данных, вплоть до полного уничтожения площадки и потери критически важной инфраструктуры.
Вторая — киберугрозы. Внешние атаки, несанкционированное проникновение в информационные системы, компрометация внутренних ресурсов и нарушение работы критически важных сервисов.
Третья — новая категория угроз, связанная с развитием искусственного интеллекта. Это не только использование ИИ для проведения более сложных и масштабных атак, но и риски потери контроля над автоматизированными процессами и системами, принимающими решения без непосредственного участия человека.
И к каждой из этих трех категорий угроз необходимо готовиться заранее, закладывая соответствующие механизмы защиты, резервирования и восстановления.
— Получается, классическая модель с одним основным и одним резервным ЦОДом уже недостаточна? Что вы предлагаете вместо нее?
— В моем понимании, один из правильных путей — гибридный формат работы.
У вас должен быть собственный центр обработки данных и одновременно облачное решение. Но здесь есть важный нюанс: я бы не рекомендовал концентрировать всю инфраструктуру у одного большого провайдера.
Если посмотреть на характер современных угроз, крупные инфраструктурные игроки могут становиться наиболее заметными целями.
Поэтому я бы рассматривал в том числе провайдеров второго и третьего эшелона. А если речь идет о большой организации — двигался бы в сторону децентрализации собственных ЦОДов.
Сейчас я занимаюсь созданием центров обработки данных в Узбекистане. Мы строим относительно небольшие площадки, в том числе до 150 стоек. Есть решения от 40 до 180 стоек.
И логика здесь достаточно простая: потеря одного небольшого ЦОДа не должна приводить к полной остановке сервиса.
На мой взгляд, это принципиально другой подход. Мы не пытаемся сделать одну площадку абсолютно неуязвимой. Мы строим инфраструктуру таким образом, чтобы потеря отдельного элемента не становилась катастрофой для всего бизнеса.
«Если у одного облачного провайдера что-то пойдет не так, последствия могут затронуть всех»
— Вы упомянули вторую угрозу — искусственный интеллект. Сейчас активно обсуждают риски автономных ИИ-агентов, которые могут действовать непредсказуемо, вмешиваться в работу систем безопасности и мониторинга. Как бизнесу защищаться от таких сценариев?
— Здесь проблема, в принципе, похожая.
Если рассматривать глобальных облачных провайдеров, то потенциально наиболее масштабные последствия могут возникать именно у крупнейших игроков.
Представим ситуацию: компания размещает свои системы в большом публичном облаке. При этом в соседнем сервисе происходит какой-то инцидент, связанный с ИИ. Условно говоря, автоматизированная система выходит из-под контроля.
И дальше возникает риск цепной реакции, когда проблема в одном компоненте затрагивает другие элементы облачной инфраструктуры.
Поэтому я считаю, что в России тоже нужно развивать архитектуру частных облаков — собственных облачных решений, развернутых внутри корпоративного контура.
Но это не означает, что нужно полностью отказываться от коммерческих ЦОДов или публичных облаков.
Я как раз сторонник гибридного размещения.
При этом инфраструктура должна быть не только распределенной, но и мультивендорной.
— То есть недостаточно разнести сервисы по разным площадкам — нужно еще и исключить зависимость от одного технологического поставщика?
— Совершенно верно.
На мой взгляд, мультивендорность должна присутствовать на разных уровнях: оборудование, сетевые решения, средства защиты, антивирусы.
Самое простое решение при построении резервной инфраструктуры — взять одного вендора и сделать всё одинаково. Это удобно с точки зрения эксплуатации.
Но с точки зрения устойчивости я бы так не делал.
Использовать разные технологические решения, чтобы отказ или уязвимость одного поставщика не затрагивали всю инфраструктуру одновременно.
Плюс необходима эшелонированная защита.
Потому что сама по себе географическая распределённость не спасает, если все ваши площадки зависят от одних и тех же технологий и подвержены одним и тем же рискам.
«Зачем всем рассказывать, где находится ваш ЦОД?»
— Вы предлагаете переходить от больших централизованных площадок к небольшим распределенным ЦОДам. Но ведь крупные дата-центры традиционно считаются более надежными и защищенными. Не возникает ли здесь противоречия?
— Я бы здесь обратил внимание еще на один момент, о котором не так часто говорят. Это физическое расположение ЦОДа и доступность информации о нем.
Когда я работал в крупных компаниях, размещение центров обработки данных зачастую не было публичной информацией.
Классический вариант — ЦОД находится внутри здания, в относительно защищенном контуре. Даже если само здание получает повреждения, это еще не означает, что серверная инфраструктура обязательно будет уничтожена.
Сегодня обсуждают строительство подземных ЦОДов. Но я не считаю, что само по себе подземное размещение решает проблему.
Если площадка становится целенаправленным объектом воздействия, могут использоваться разные технические способы вывести ее из строя, не обязательно связанные с прямым физическим разрушением.
Поэтому, на мой взгляд, нужно думать не только о том, насколько хорошо защищен ЦОД, но и о том, насколько легко его вообще обнаружить.
— Вы хотите сказать, что одна из стратегий защиты — просто не афишировать расположение дата-центра?
— Да. И я считаю это очень важным.
Посмотрите, как традиционно происходило открытие крупных центров обработки данных. Торжественная церемония, разрезание ленточки, фотографии, публикации, информация о расположении площадки.
Фактически все желающие могли узнать, где находится объект.
А зачем?
Если бизнес действительно хочет защитить критическую инфраструктуру, я считаю, что информация о ее размещении должна быть максимально ограничена.
Мы, например, используем контейнерные решения, которые внешне не обязательно должны выглядеть как классический ЦОД. Это может быть инфраструктурный модуль, визуально напоминающий обычный технический объект.
Возможны и варианты размещения внутри существующих зданий, ангаров, других относительно защищенных сооружений.
Смысл не в том, чтобы построить какое-то фантастическое подземное убежище. Смысл в том, чтобы небольшая площадка находилась в защищенном контуре и не привлекала лишнего внимания.
Мне кажется, бизнесу стоит пересмотреть сам подход к публичности критической инфраструктуры.
Потому что возникает довольно странная ситуация: мы инвестируем огромные деньги в защиту ЦОДов, а потом сами публикуем подробную информацию об их расположении.
«Резервирование работает. Но скоро возникнет другая проблема»
— А насколько вообще эффективны существующие стратегии резервирования и аварийного восстановления? Последние инциденты показывают, что рынок готов к таким ситуациям, или, наоборот, обнаруживают слабые места?
— Я считаю, что в целом существующие механизмы достаточно эффективны.
Если посмотреть на опыт Яндекса и VK, мы видим, что компании способны достаточно быстро восстанавливать работу сервисов и перераспределять ресурсы между площадками.
В качестве примера можно привести VK, где используется собственное решение OneCloud – облачная инфраструктура, позволяющая эффективно масштабировать ресурсы горизонтально между несколькими центрами обработки данных.
Именно такие архитектурные возможности помогают обеспечивать непрерывность работы.
Но сейчас, на мой взгляд, рынок столкнется с другой проблемой.
Если значительные вычислительные мощности выбывают из эксплуатации, возникает вопрос: чем их замещать?
Стоимость оборудования может существенно вырасти. Сроки поставок — тоже.
И это означает, что бизнесу придется гораздо внимательнее относиться к уже имеющимся вычислительным ресурсам.
Раньше можно было решить многие проблемы производительности относительно просто: докупить серверы, добавить память, увеличить дисковую подсистему.
Сейчас такой подход будет становиться всё дороже.
Поэтому нам придется научиться размещать больше бизнес-систем на существующих мощностях, повышать производительность приложений без пропорционального роста нагрузки на процессоры, память и диски.
И я считаю, что это один из главных вызовов для российского IT на ближайшие несколько лет.
«Клиенту важнее увидеть баланс, чем историю операций»
— Но здесь возникает вопрос экономики. Распределенные ЦОДы, гибридная инфраструктура, мультивендорность — всё это требует инвестиций. Как снижать риски, не увеличивая бюджеты на инфраструктуру в несколько раз?
— Первое, что я бы сказал: не надо резервировать всё.
Нам нужно точно понимать, какие ресурсы являются максимально критичными для наших клиентов, и в первую очередь обеспечивать работу именно этих ресурсов.
Возьмем финансовую организацию.
Что для клиента действительно важно? Чтобы он мог увидеть свой баланс и совершить операцию.
А если клиент временно не сможет посмотреть историю операций или оформить новый продукт, это, конечно, неприятно, но не настолько критично.
Соответственно, именно те сервисы, от которых зависит выполнение базовых клиентских операций, должны быть максимально географически распределены и защищены.
Это необходимо учитывать еще на этапе архитектурного проектирования и подготовки disaster recovery plan — плана аварийного восстановления.
Нельзя подходить к резервированию по принципу «давайте продублируем вообще всё».
Нужно определить критичность каждого сервиса и исходя из этого распределять ресурсы.
— То есть вы предлагаете бизнесу отказаться от идеи одинаковой отказоустойчивости для всех систем?
— Да, потому что у разных систем разная критичность.
И если мы хотим не увеличивать бюджет кратно, мы должны очень четко расставлять приоритеты.
В первую очередь защищаем то, без чего клиент не может получить основную услугу.
Всё остальное может иметь другие требования к восстановлению.
И это не означает, что второстепенные системы вообще не нужно резервировать. Это означает, что архитектура должна соответствовать реальной бизнес-критичности сервисов.
«Раньше посчитали сайзинг — и пошли покупать железо. Сейчас так работать не получится»
— Если вернуться к вопросу стоимости оборудования: получается, бизнесу придется пересматривать не только инфраструктуру, но и архитектуру самих приложений?
— Безусловно.
Раньше как было? Мы делали сайзинг, определяли, сколько оборудования нам нужно, приходили с бюджетом и закупали необходимое железо.
Во многих случаях эти бюджеты согласовывались, потому что бизнес рос и требовал дополнительных мощностей.
Сейчас так работать уже не получится.
Нужно менять архитектуру приложений таким образом, чтобы на том же оборудовании можно было обрабатывать кратно больший объем клиентских транзакций.
Для этого есть разные технические решения. В том числе более легковесные языки программирования, оптимизация работы с процессором, памятью, дисковой подсистемой.
То есть вопрос уже не только в том, сколько у вас серверов, но и в том, насколько эффективно вы используете каждый из них.
Бизнес, который продолжает расти, неизбежно столкнется с необходимостью приобретать новое оборудование.
И здесь будет две проблемы.
Первая — сама возможность покупки и сроки поставки.
Вторая — цена.
Причем это касается не только России. На международном рынке тоже есть предпосылки к удорожанию вычислительных мощностей. А в России ситуация дополнительно осложняется санкционными ограничениями.
Поэтому, на мой взгляд, ближайшие годы потребуют от IT-команд совершенно другого подхода к эффективности.
Мы должны научиться решать больше задач меньшим количеством оборудования.
И при этом не терять в надежности.
А как считаете вы?
Что сегодня важнее для устойчивости бизнеса: мощные централизованные ЦОДы или сеть небольших распределенных площадок? И готовы ли компании отказаться от резервирования всех систем ради гарантированной доступности только самых критичных сервисов?
Приглашаем обсудить: как вы пересматриваете стратегии отказоустойчивости, какие риски считаете наиболее серьезными и где, на ваш взгляд, проходит разумная граница между надежностью и стоимостью инфраструктуры?